机器人对自身状态的了解全部来自间接证据:编码器会漂移、IMU 会有偏置、相机会丢帧、激光会被玻璃骗。状态估计要回答的问题是:
给定一串有噪声的控制输入和一串有噪声的观测,机器人此刻的状态(位置、速度、姿态……)最可能是什么?置信度多大?
卡尔曼滤波(Kalman Filter,KF)是这个问题在“线性系统 + 高斯噪声”假设下的精确最优解 ,也是几乎所有实用估计器(EKF、UKF、ESKF、MSCKF)的骨架。本文从贝叶斯滤波推起,让卡尔曼增益的每一项都有出处,再讲清楚非线性化的 EKF 和真正决定成败的工程细节。
把机器人状态记为 x k \mathbf x_k x k u k \mathbf u_k u k z k \mathbf z_k z k 后验分布 (belief):
b e l ( x k ) = p ( x k ∣ z 1 : k , u 1 : k ) bel(\mathbf x_k) = p\left(\mathbf x_k \mid \mathbf z_{1:k}, \mathbf u_{1:k}\right) b e l ( x k ) = p ( x k ∣ z 1 : k , u 1 : k )
在马尔可夫假设(状态完备:x k \mathbf x_k x k x k − 1 \mathbf x_{k-1} x k − 1 u k \mathbf u_k u k
预测 (用运动模型把上一时刻的 belief 推向前):
b e l ‾ ( x k ) = ∫ p ( x k ∣ x k − 1 , u k ) b e l ( x k − 1 ) d x k − 1 \overline{bel}(\mathbf x_k) = \int p\left(\mathbf x_k \mid \mathbf x_{k-1}, \mathbf u_k\right), bel(\mathbf x_{k-1}), \mathrm d \mathbf x_{k-1} b e l ( x k ) = ∫ p ( x k ∣ x k − 1 , u k ) b e l ( x k − 1 ) d x k − 1
更新 (用观测似然对预测做贝叶斯修正):
b e l ( x k ) = η p ( z k ∣ x k ) b e l ‾ ( x k ) bel(\mathbf x_k) = \eta; p\left(\mathbf z_k \mid \mathbf x_k\right), \overline{bel}(\mathbf x_k) b e l ( x k ) = η p ( z k ∣ x k ) b e l ( x k )
这个递推对任意分布成立,但一般情况下积分算不动。粒子滤波用采样近似分布;直方图滤波用网格近似;卡尔曼滤波的选择是:假设一切都是高斯的、模型都是线性的,此时递推有闭式解,且高斯性永远保持 。
线性高斯系统:
x k = A x k − 1 + B u k + w k , w k ∼ N ( 0 , Q ) z k = H x k + v k , v k ∼ N ( 0 , R ) \begin{aligned}
\mathbf x_k &= \mathbf A \mathbf x_{k-1} + \mathbf B \mathbf u_k + \mathbf w_k, \qquad \mathbf w_k \sim \mathcal N(\mathbf 0, \mathbf Q) \
\mathbf z_k &= \mathbf H \mathbf x_k + \mathbf v_k, \qquad\qquad\quad;; \mathbf v_k \sim \mathcal N(\mathbf 0, \mathbf R)
\end{aligned} x k z k = A x k − 1 + B u k + w k , w k ∼ N ( 0 , Q ) = H x k + v k , v k ∼ N ( 0 , R )
belief 用均值和协方差 ( x ^ , P ) (\hat{\mathbf x}, \mathbf P) ( x ^ , P )
预测 (高斯经过线性变换仍是高斯):
x ^ k − = A x ^ k − 1 + B u k P k − = A P k − 1 A ⊤ + Q \begin{aligned}
\hat{\mathbf x}k^- &= \mathbf A \hat{\mathbf x} {k-1} + \mathbf B \mathbf u_k \
\mathbf P_k^- &= \mathbf A \mathbf P_{k-1} \mathbf A^\top + \mathbf Q
\end{aligned} x ^ k − P k − = A x ^ k − 1 + B u k = A P k − 1 A ⊤ + Q
协方差方程可以直接从误差的定义推出来:记估计误差 e k − 1 = x k − 1 − x ^ k − 1 \mathbf e_{k-1} = \mathbf x_{k-1} - \hat{\mathbf x}_{k-1} e k − 1 = x k − 1 − x ^ k − 1 e k − = A e k − 1 + w k \mathbf e_k^- = \mathbf A \mathbf e_{k-1} + \mathbf w_k e k − = A e k − 1 + w k w k \mathbf w_k w k
P k − = E [ e k − ( e k − ) ⊤ ] = A E [ e k − 1 e k − 1 ⊤ ] A ⊤ + E [ w k w k ⊤ ] = A P k − 1 A ⊤ + Q \mathbf P_k^- = \mathbb E\left[\mathbf e_k^- (\mathbf e_k^-)^\top\right]
= \mathbf A, \mathbb E[\mathbf e_{k-1}\mathbf e_{k-1}^\top], \mathbf A^\top + \mathbb E[\mathbf w_k \mathbf w_k^\top]
= \mathbf A \mathbf P_{k-1} \mathbf A^\top + \mathbf Q P k − = E [ e k − ( e k − ) ⊤ ] = A E [ e k − 1 e k − 1 ⊤ ] A ⊤ + E [ w k w k ⊤ ] = A P k − 1 A ⊤ + Q
均值按模型外推;协方差经模型传播后加上 Q \mathbf Q Q
更新 (两个高斯相乘仍是高斯):
K k = P k − H ⊤ ( H P k − H ⊤ + R ) − 1 x ^ k = x ^ k − + K k ( z k − H x ^ k − ) ⏟ 新息 y k P k = ( I − K k H ) P k − \begin{aligned}
\mathbf K_k &= \mathbf P_k^- \mathbf H^\top \left(\mathbf H \mathbf P_k^- \mathbf H^\top + \mathbf R\right)^{-1} \
\hat{\mathbf x}_k &= \hat{\mathbf x}_k^- + \mathbf K_k \underbrace{\left(\mathbf z_k - \mathbf H \hat{\mathbf x}k^-\right)} {\text{新息 } \mathbf y_k} \
\mathbf P_k &= \left(\mathbf I - \mathbf K_k \mathbf H\right) \mathbf P_k^-
\end{aligned} K k x ^ k P k = P k − H ⊤ ( H P k − H ⊤ + R ) − 1 = x ^ k − + K k 新息 y k ( z k − H x ^ k − ) = ( I − K k H ) P k −
这三个方程是全书最需要“知其所以然”的地方,值得完整推一遍。思路:不预设任何最优理论,只假设更新是“预测加新息的线性修正”,然后问哪个修正矩阵让更新后误差最小。
设 x ^ k = x ^ k − + K y k \hat{\mathbf x}_k = \hat{\mathbf x}_k^- + \mathbf K \mathbf y_k x ^ k = x ^ k − + K y k K \mathbf K K
e k = x k − x ^ k = e k − − K ( H x k + v k − H x ^ k − ) = ( I − K H ) e k − − K v k \mathbf e_k = \mathbf x_k - \hat{\mathbf x}_k
= \mathbf e_k^- - \mathbf K\left(\mathbf H \mathbf x_k + \mathbf v_k - \mathbf H\hat{\mathbf x}_k^-\right)
= (\mathbf I - \mathbf K\mathbf H), \mathbf e_k^- - \mathbf K \mathbf v_k e k = x k − x ^ k = e k − − K ( H x k + v k − H x ^ k − ) = ( I − KH ) e k − − K v k
e k − \mathbf e_k^- e k − v k \mathbf v_k v k K \mathbf K K 任意 K \mathbf K K
P k ( K ) = ( I − K H ) P k − ( I − K H ) ⊤ + K R K ⊤ \mathbf P_k(\mathbf K) = (\mathbf I - \mathbf K\mathbf H), \mathbf P_k^- (\mathbf I - \mathbf K\mathbf H)^\top + \mathbf K \mathbf R \mathbf K^\top P k ( K ) = ( I − KH ) P k − ( I − KH ) ⊤ + KR K ⊤
“误差最小”取均方误差 E [ ∥ e k ∥ 2 ] = tr P k \mathbb E[\|\mathbf e_k\|^2] = \operatorname{tr} \mathbf P_k E [ ∥ e k ∥ 2 ] = tr P k K \mathbf K K ∂ ∂ K tr ( K S K ⊤ ) = 2 K S \tfrac{\partial}{\partial \mathbf K}\operatorname{tr}(\mathbf K \mathbf S \mathbf K^\top) = 2\mathbf K\mathbf S ∂ K ∂ tr ( KS K ⊤ ) = 2 KS ∂ ∂ K tr ( K U ⊤ ) = U \tfrac{\partial}{\partial \mathbf K}\operatorname{tr}(\mathbf K \mathbf U^\top) = \mathbf U ∂ K ∂ tr ( K U ⊤ ) = U
∂ tr P k ∂ K = − 2 ( P k − ) H ⊤ + 2 K ( H P k − H ⊤ + R ) = 0 \frac{\partial \operatorname{tr}\mathbf P_k}{\partial \mathbf K}
= -2,(\mathbf P_k^-)\mathbf H^\top + 2,\mathbf K\left(\mathbf H \mathbf P_k^- \mathbf H^\top + \mathbf R\right) = \mathbf 0 ∂ K ∂ tr P k = − 2 ( P k − ) H ⊤ + 2 K ( H P k − H ⊤ + R ) = 0
括号里的矩阵正是新息的协方差 S = H P k − H ⊤ + R \mathbf S = \mathbf H \mathbf P_k^- \mathbf H^\top + \mathbf R S = H P k − H ⊤ + R y k = H e k − + v k \mathbf y_k = \mathbf H\mathbf e_k^- + \mathbf v_k y k = H e k − + v k
K k = P k − H ⊤ S − 1 \mathbf K_k = \mathbf P_k^- \mathbf H^\top \mathbf S^{-1} K k = P k − H ⊤ S − 1
——增益的结构是“状态与观测的互协方差 × \times × 新息里每一分信息按它的可信度折算成状态修正 。把最优 K k \mathbf K_k K k
P k = ( I − K k H ) P k − \mathbf P_k = (\mathbf I - \mathbf K_k \mathbf H),\mathbf P_k^- P k = ( I − K k H ) P k −
注意这个简洁形式只在 K \mathbf K K ;数值实现中若增益被修改过(比如做了限幅),必须退回 Joseph 形式更新协方差,否则 P \mathbf P P
同一组公式也可以从贝叶斯路线得到:把 b e l ‾ \overline{bel} b e l x k \mathbf x_k x k 线性高斯情形下 MMSE 最优解与贝叶斯后验是同一个东西 ,这就是正文说“不是近似,是最优”的依据。
一个周期:运动模型把后验推前并拉宽(预测),观测似然与预测加权融合,得到更窄的新后验(更新)
看一维标量情形,增益退化为
K = P − P − + R K = \frac{P^-}{P^- + R} K = P − + R P −
更新后的均值是 x ^ = x ^ − + K ( z − x ^ − ) = ( 1 − K ) x ^ − + K z \hat x = \hat x^- + K(z - \hat x^-) = (1-K)\,\hat x^- + K z x ^ = x ^ − + K ( z − x ^ − ) = ( 1 − K ) x ^ − + K z 预测和观测的加权平均,权重是各自精度(方差的倒数) :
观测很准(R → 0 R \to 0 R → 0 K → 1 K \to 1 K → 1
预测很准(P − → 0 P^- \to 0 P − → 0 K → 0 K \to 0 K → 0
更新后方差 P = ( 1 − K ) P − = P − R P − + R ≤ min ( P − , R ) P = (1-K)P^- = \dfrac{P^- R}{P^- + R} \le \min(P^-, R) P = ( 1 − K ) P − = P − + R P − R ≤ min ( P − , R ) 融合之后一定比两个来源各自都更确定 。
这就是卡尔曼滤波的全部直觉:它不是什么魔法平滑器,而是按噪声统计自动调节权重的递推最小二乘 。矩阵形式只是把“方差”换成协方差矩阵、把标量除法换成矩阵求逆。
在线性高斯假设成立时,这个解是精确的贝叶斯后验,同时也是最小均方误差(MMSE)意义下的最优估计——不是近似,是最优。
机器人模型几乎都非线性——差速底盘的运动学有 cos θ , sin θ \cos\theta, \sin\theta cos θ , sin θ
x k = f ( x k − 1 , u k ) + w k , z k = h ( x k ) + v k \mathbf x_k = f(\mathbf x_{k-1}, \mathbf u_k) + \mathbf w_k, \qquad
\mathbf z_k = h(\mathbf x_k) + \mathbf v_k x k = f ( x k − 1 , u k ) + w k , z k = h ( x k ) + v k
高斯分布经过非线性函数不再是高斯。EKF 的妥协是:均值直接过非线性函数,协方差用当前估计点的一阶泰勒展开(雅可比)传播 :
F k = ∂ f ∂ x ∣ x ^ k − 1 , u k , H k = ∂ h ∂ x ∣ x ^ k − \mathbf F_k = \left.\frac{\partial f}{\partial \mathbf x}\right|{\hat{\mathbf x} {k-1}, \mathbf u_k}, \qquad
\mathbf H_k = \left.\frac{\partial h}{\partial \mathbf x}\right|_{\hat{\mathbf x}_k^-} F k = ∂ x ∂ f x ^ k − 1 , u k , H k = ∂ x ∂ h x ^ k −
五个方程里把 A → F k \mathbf A \to \mathbf F_k A → F k H → H k \mathbf H \to \mathbf H_k H → H k f ( ⋅ ) f(\cdot) f ( ⋅ ) z k − h ( x ^ k − ) \mathbf z_k - h(\hat{\mathbf x}_k^-) z k − h ( x ^ k − )
状态 x = [ x , y , θ ] ⊤ \mathbf x = [x, y, \theta]^\top x = [ x , y , θ ] ⊤ [ Δ s , Δ θ ] [\Delta s, \Delta\theta] [ Δ s , Δ θ ]
f ( x , u ) = [ x + Δ s cos ( θ + Δ θ / 2 ) y + Δ s sin ( θ + Δ θ / 2 ) θ + Δ θ ] ⟹ F = [ 1 0 − Δ s sin ( θ + Δ θ / 2 ) 0 1 − Δ s cos ( θ + Δ θ / 2 ) 0 0 1 ] f(\mathbf x, \mathbf u) =
\begin{bmatrix}
x + \Delta s \cos(\theta + \Delta\theta/2) \
y + \Delta s \sin(\theta + \Delta\theta/2) \
\theta + \Delta\theta
\end{bmatrix}
;\Longrightarrow;
\mathbf F =
\begin{bmatrix}
1 & 0 & -\Delta s \sin(\theta + \Delta\theta/2) \
0 & 1 & \phantom{-}\Delta s \cos(\theta + \Delta\theta/2) \
0 & 0 & 1
\end{bmatrix} f ( x , u ) = x + Δ s cos ( θ + Δ θ /2 ) y + Δ s sin ( θ + Δ θ /2 ) θ + Δ θ ⟹ F = 1 0 0 0 1 0 − Δ s sin ( θ + Δ θ /2 ) − Δ s cos ( θ + Δ θ /2 ) 1
F \mathbf F F 朝向不确定度会随着走过的距离放大成位置不确定度 ——这就是纯里程计航位推算发散的机制,也是必须融合外部观测(UWB、路标、回环)的原因。
观测一个已知位置 ( m x , m y ) (m_x, m_y) ( m x , m y )
h ( x ) = [ q atan2 ( m y − y , m x − x ) − θ ] , q = ( m x − x ) 2 + ( m y − y ) 2 h(\mathbf x) = \begin{bmatrix} \sqrt{q} \ \operatorname{atan2}(m_y - y,; m_x - x) - \theta \end{bmatrix},
\qquad q = (m_x - x)^2 + (m_y - y)^2 h ( x ) = [ q atan2 ( m y − y , m x − x ) − θ ] , q = ( m x − x ) 2 + ( m y − y ) 2
对 x \mathbf x x H k \mathbf H_k H k ( − π , π ] (-\pi, \pi] ( − π , π ]
线性化误差在两种情况下不可忽视:非线性在当前不确定度范围内变化剧烈 (比如方位角观测、距离很近的路标),以及初值差 (线性化点本身就错,雅可比也跟着错,可能发散)。缓解手段按代价递增:
缩短周期、提高更新频率,让每步的增量更小;
迭代 EKF(IEKF):更新步内在新估计点重新线性化,迭代几次;
UKF:不算雅可比,用确定性采样的 sigma 点过非线性函数,精度到二阶,代价是约 2 n + 1 2n+1 2 n + 1
姿态估计用误差状态卡尔曼滤波(ESKF) :名义状态用四元数全量积分,滤波器只估计小的误差状态——误差小意味着线性化好,这是 VIO/组合导航的标准做法。
滤波器方程五分钟能抄完,调 Q \mathbf Q Q R \mathbf R R 。
R \mathbf R R Q \mathbf Q Q
Q \mathbf Q Q Q \mathbf Q Q 过度自信 (P \mathbf P P 过度自信比欠自信危险得多——欠自信只是噪声大,过度自信是发散的前兆。
验证工具是新息一致性检验 。新息 y k \mathbf y_k y k S k = H P k − H ⊤ + R \mathbf S_k = \mathbf H \mathbf P_k^- \mathbf H^\top + \mathbf R S k = H P k − H ⊤ + R
ϵ k = y k ⊤ S k − 1 y k ∼ χ 2 ( dim z ) \epsilon_k = \mathbf y_k^\top \mathbf S_k^{-1} \mathbf y_k \sim \chi^2(\dim \mathbf z) ϵ k = y k ⊤ S k − 1 y k ∼ χ 2 ( dim z )
应服从卡方分布。批量回放数据,统计 ϵ k \epsilon_k ϵ k Q \mathbf Q Q R \mathbf R R 野值门限 :单次 ϵ k \epsilon_k ϵ k χ 2 \chi^2 χ 2
数值细节还有两处:协方差更新用 Joseph 形式 P = ( I − K H ) P − ( I − K H ) ⊤ + K R K ⊤ \mathbf P = (\mathbf I - \mathbf K\mathbf H)\mathbf P^-(\mathbf I - \mathbf K\mathbf H)^\top + \mathbf K\mathbf R\mathbf K^\top P = ( I − KH ) P − ( I − KH ) ⊤ + KR K ⊤ 每种观测到了就做各自的更新 ,天然支持异步融合——这正是 KF 结构优雅的地方。
flowchart TD
A[IMU / 里程计 到达] --> B[预测:均值外推<br/>P ← FPF^T + Q]
B --> C{有观测到达?}
C -- 否 --> A
C -- 是 --> D[计算新息 y 与 S<br/>角度残差卷绕]
D --> E{NIS 卡方检验通过?}
E -- 否,野值 --> F[拒绝该观测] --> A
E -- 是 --> G[K = P H^T S^-1<br/>更新均值与协方差]
G --> A
方法
假设
代价
适用
KF
线性 + 高斯
一次矩阵求逆
目标跟踪、简单融合
EKF
弱非线性,一阶展开够用
额外算两个雅可比
轮式定位、GPS/INS
UKF
中等非线性
2 n + 1 2n{+}1 2 n + 1 雅可比难求或非线性强
ESKF
姿态在流形上
与 EKF 相当
IMU 姿态、VIO
粒子滤波
任意分布(多峰)
数百~数千粒子
全局定位、绑架恢复
三条经验总结:
卡尔曼滤波是按精度加权的递推平均 ,不是平滑器;如果只想要平滑,低通滤波器更便宜也更诚实。
方程是标准的,功夫全在建模 :状态选取(要不要把 IMU 偏置放进状态里?要)、噪声整定、残差卷绕、野值剔除。
滤波器不会报告“我错了”,它只会给出一个越来越自信的错误答案——一致性监控(NIS/NEES)必须是系统的一部分 ,而不是调试时才看一眼的曲线。
S. Thrun, W. Burgard, D. Fox. Probabilistic Robotics . MIT Press.(贝叶斯滤波框架的标准出处)
Y. Bar-Shalom, X. R. Li, T. Kirubarajan. Estimation with Applications to Tracking and Navigation . Wiley.(一致性检验、NIS/NEES)
J. Solà. Quaternion kinematics for the error-state Kalman filter . arXiv:1711.02508.(ESKF 推导)
R. E. Kalman. A New Approach to Linear Filtering and Prediction Problems . 1960.(原始论文)
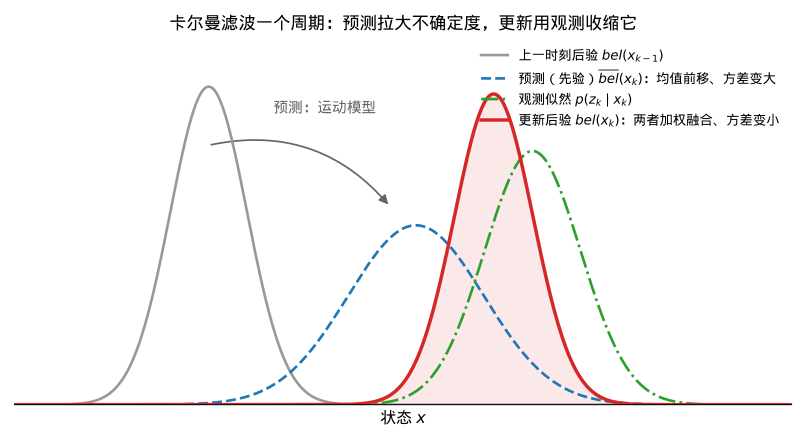 一个周期:运动模型把后验推前并拉宽(预测),观测似然与预测加权融合,得到更窄的新后验(更新)